
Nemotron 3.5 Bolt
ストックにはログインが必要です
24GB GPU上で日常的なエージェントタスクをローカル実行
Artificial Intelligence
概要
- Nemotron 3.5 Boltは、24GBのメモリ容量に収まるよう設計されたオープンウェイトの視覚・言語モデルで、NVIDIA RTXやDGX Spark上で動作します。
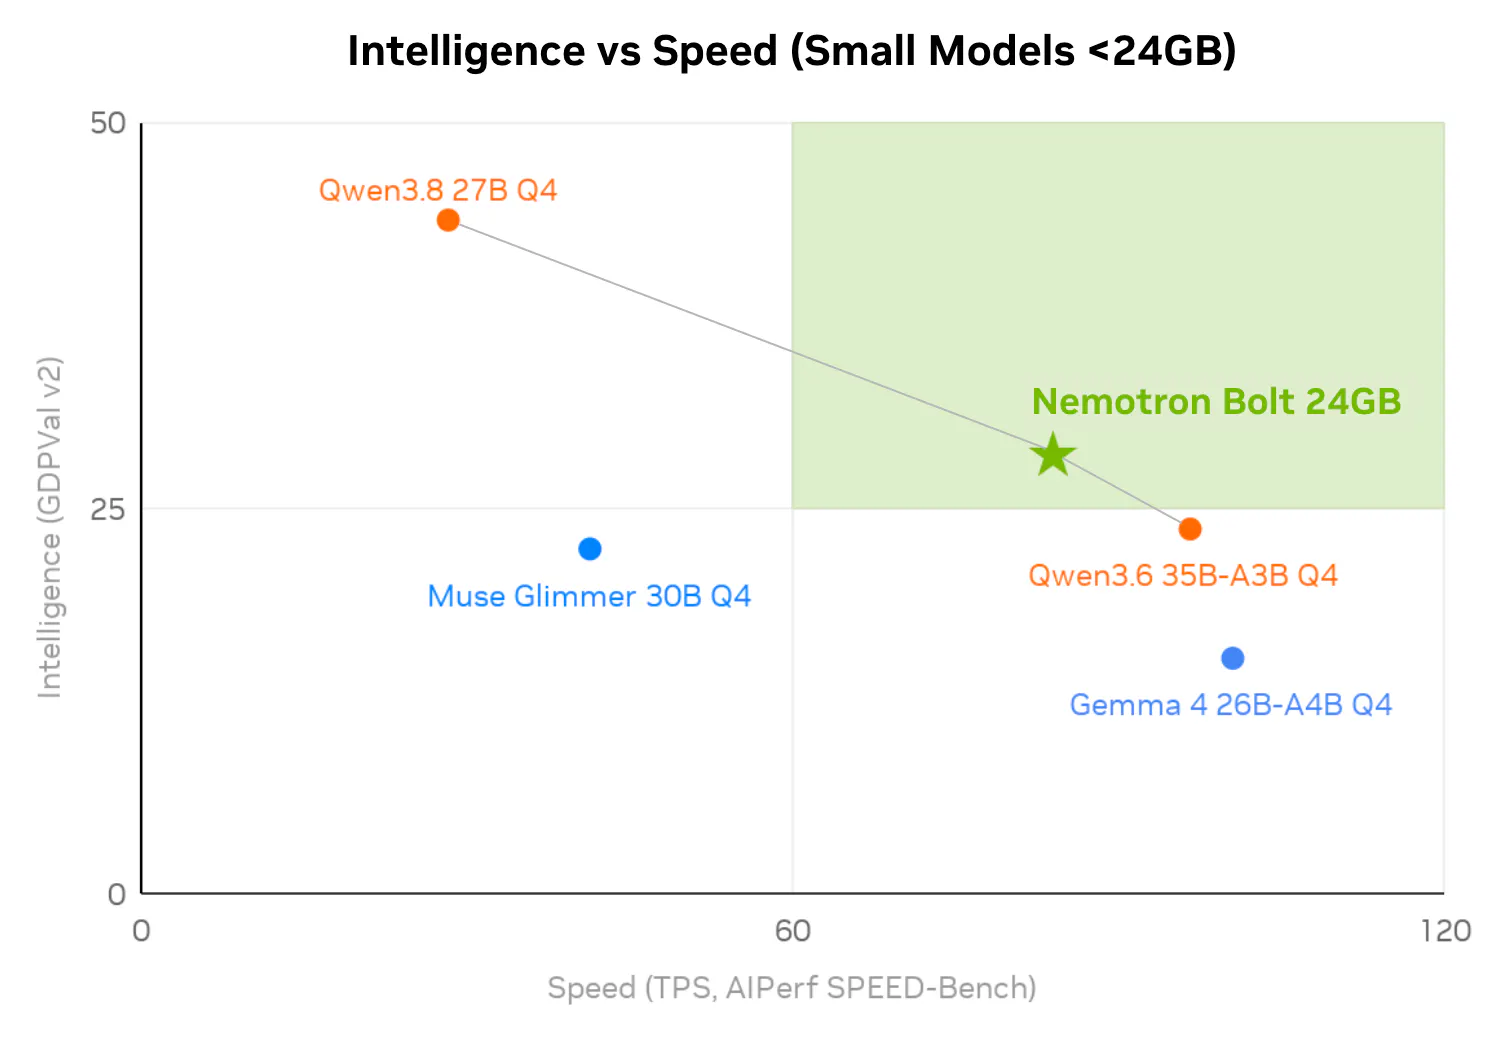
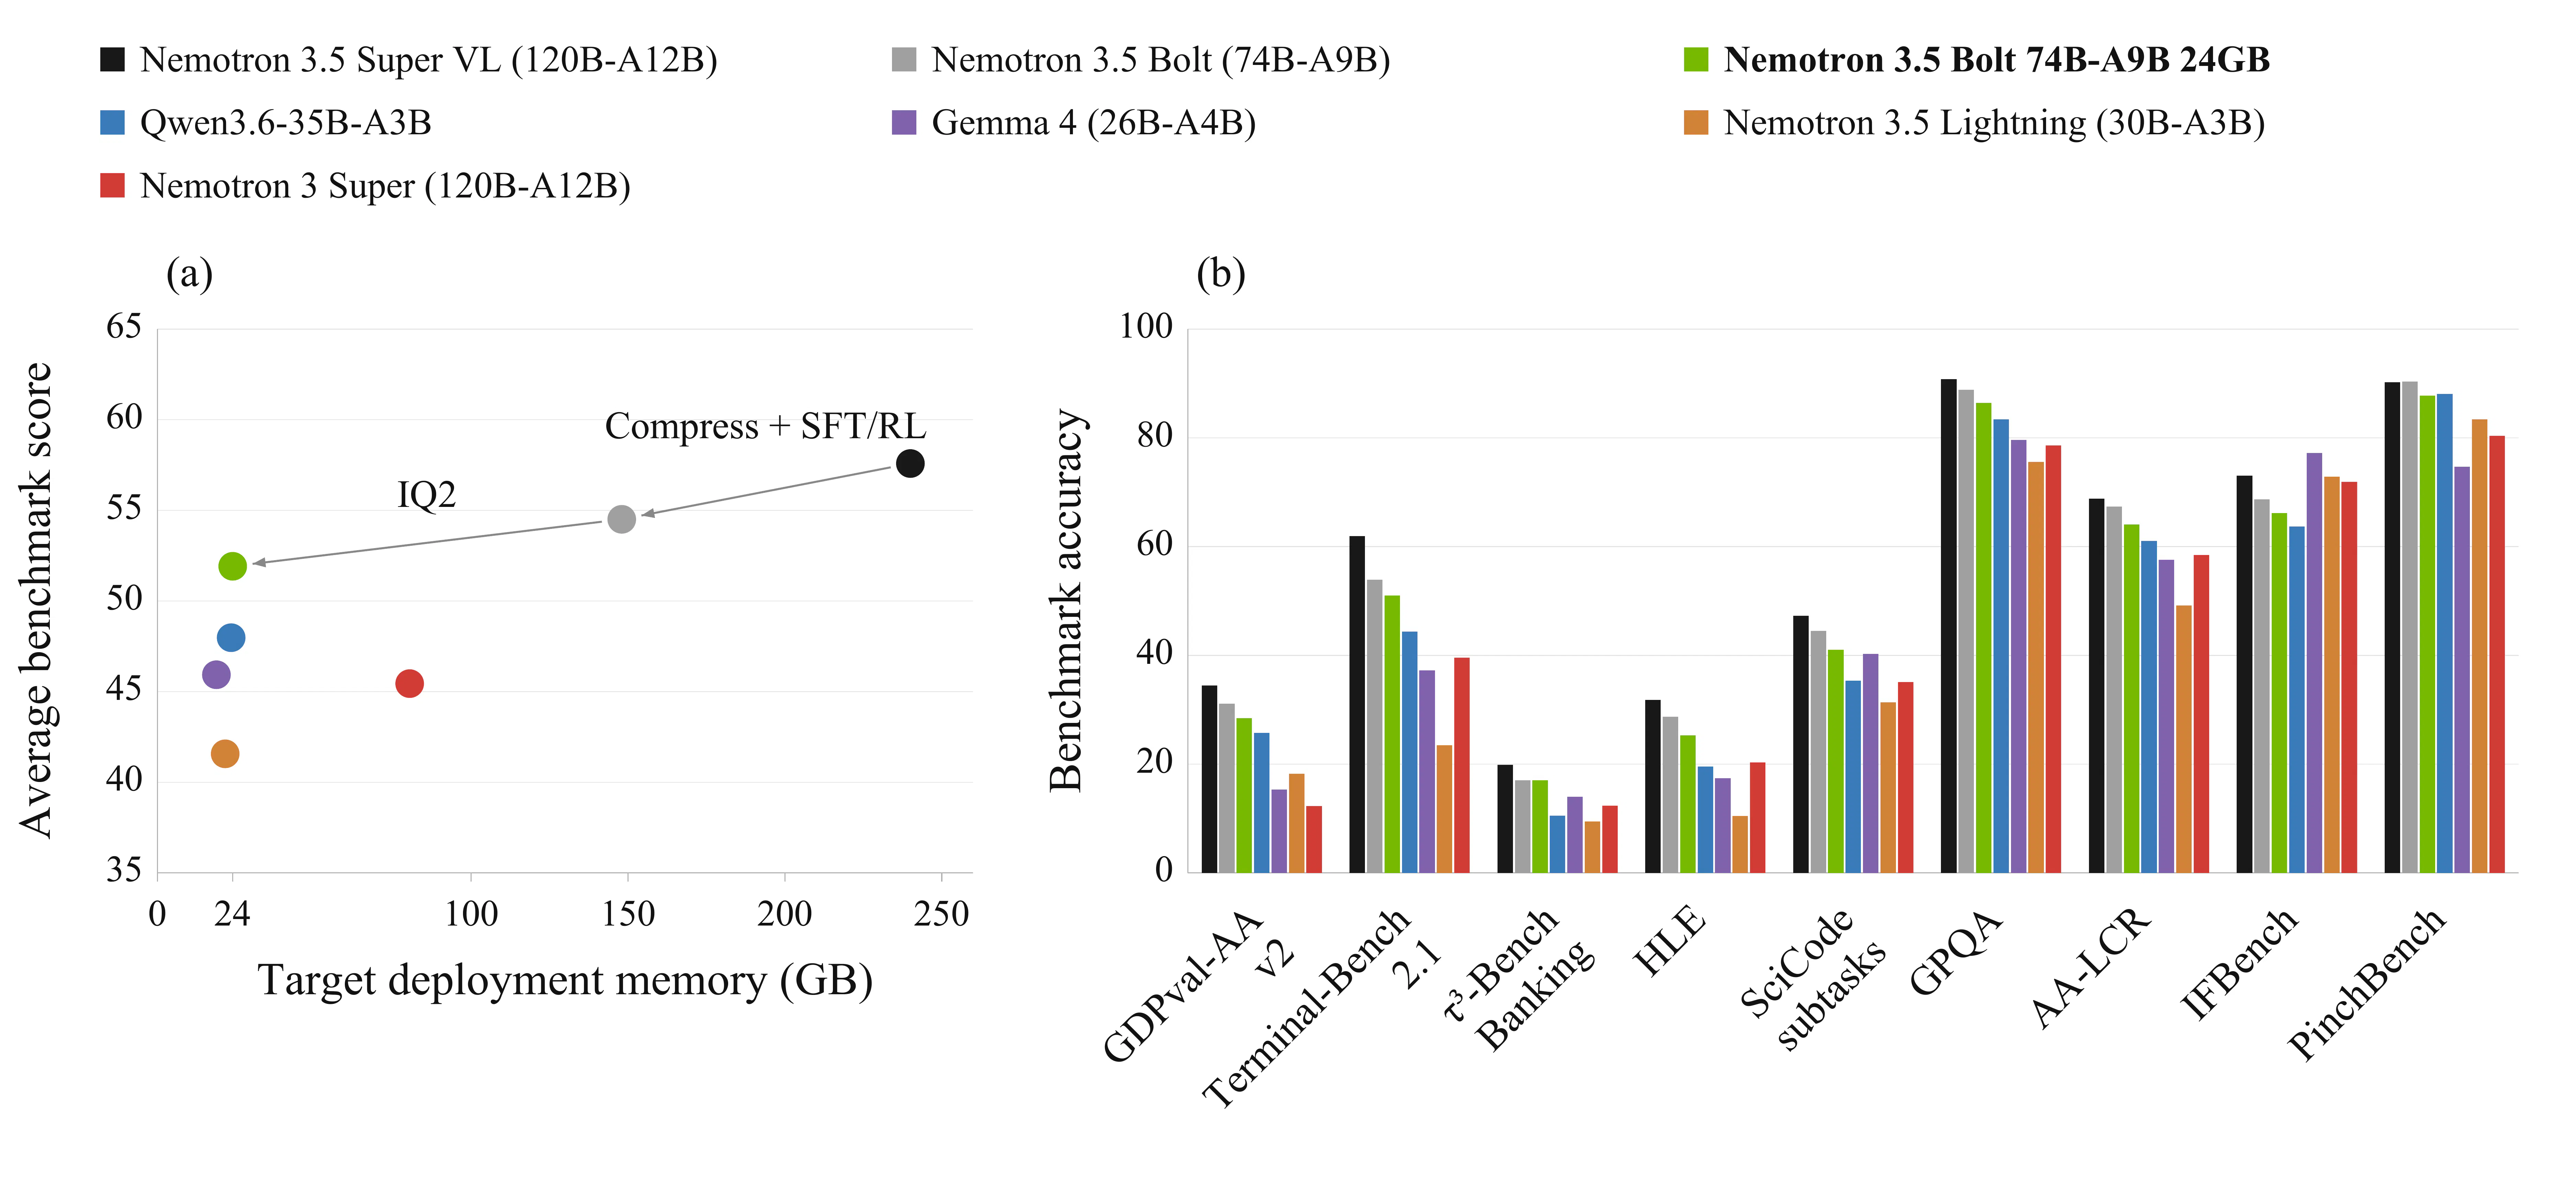
- 大規模モデルを圧縮し、総パラメータ数74B・アクティブパラメータ数9Bを実現。テキストと画像を扱うローカルAI基盤を提供します。
主な特徴
- 積極的な2ビット量子化によって、限られたメモリ容量でも大規模モデルの能力をできるだけ維持し、ローカル実行に適した構成にしています。
- スペキュレーティブデコーディングを採用し、NVIDIAのRTX Sparkベンチマークでは毎秒約84トークンの生成速度を報告しています。
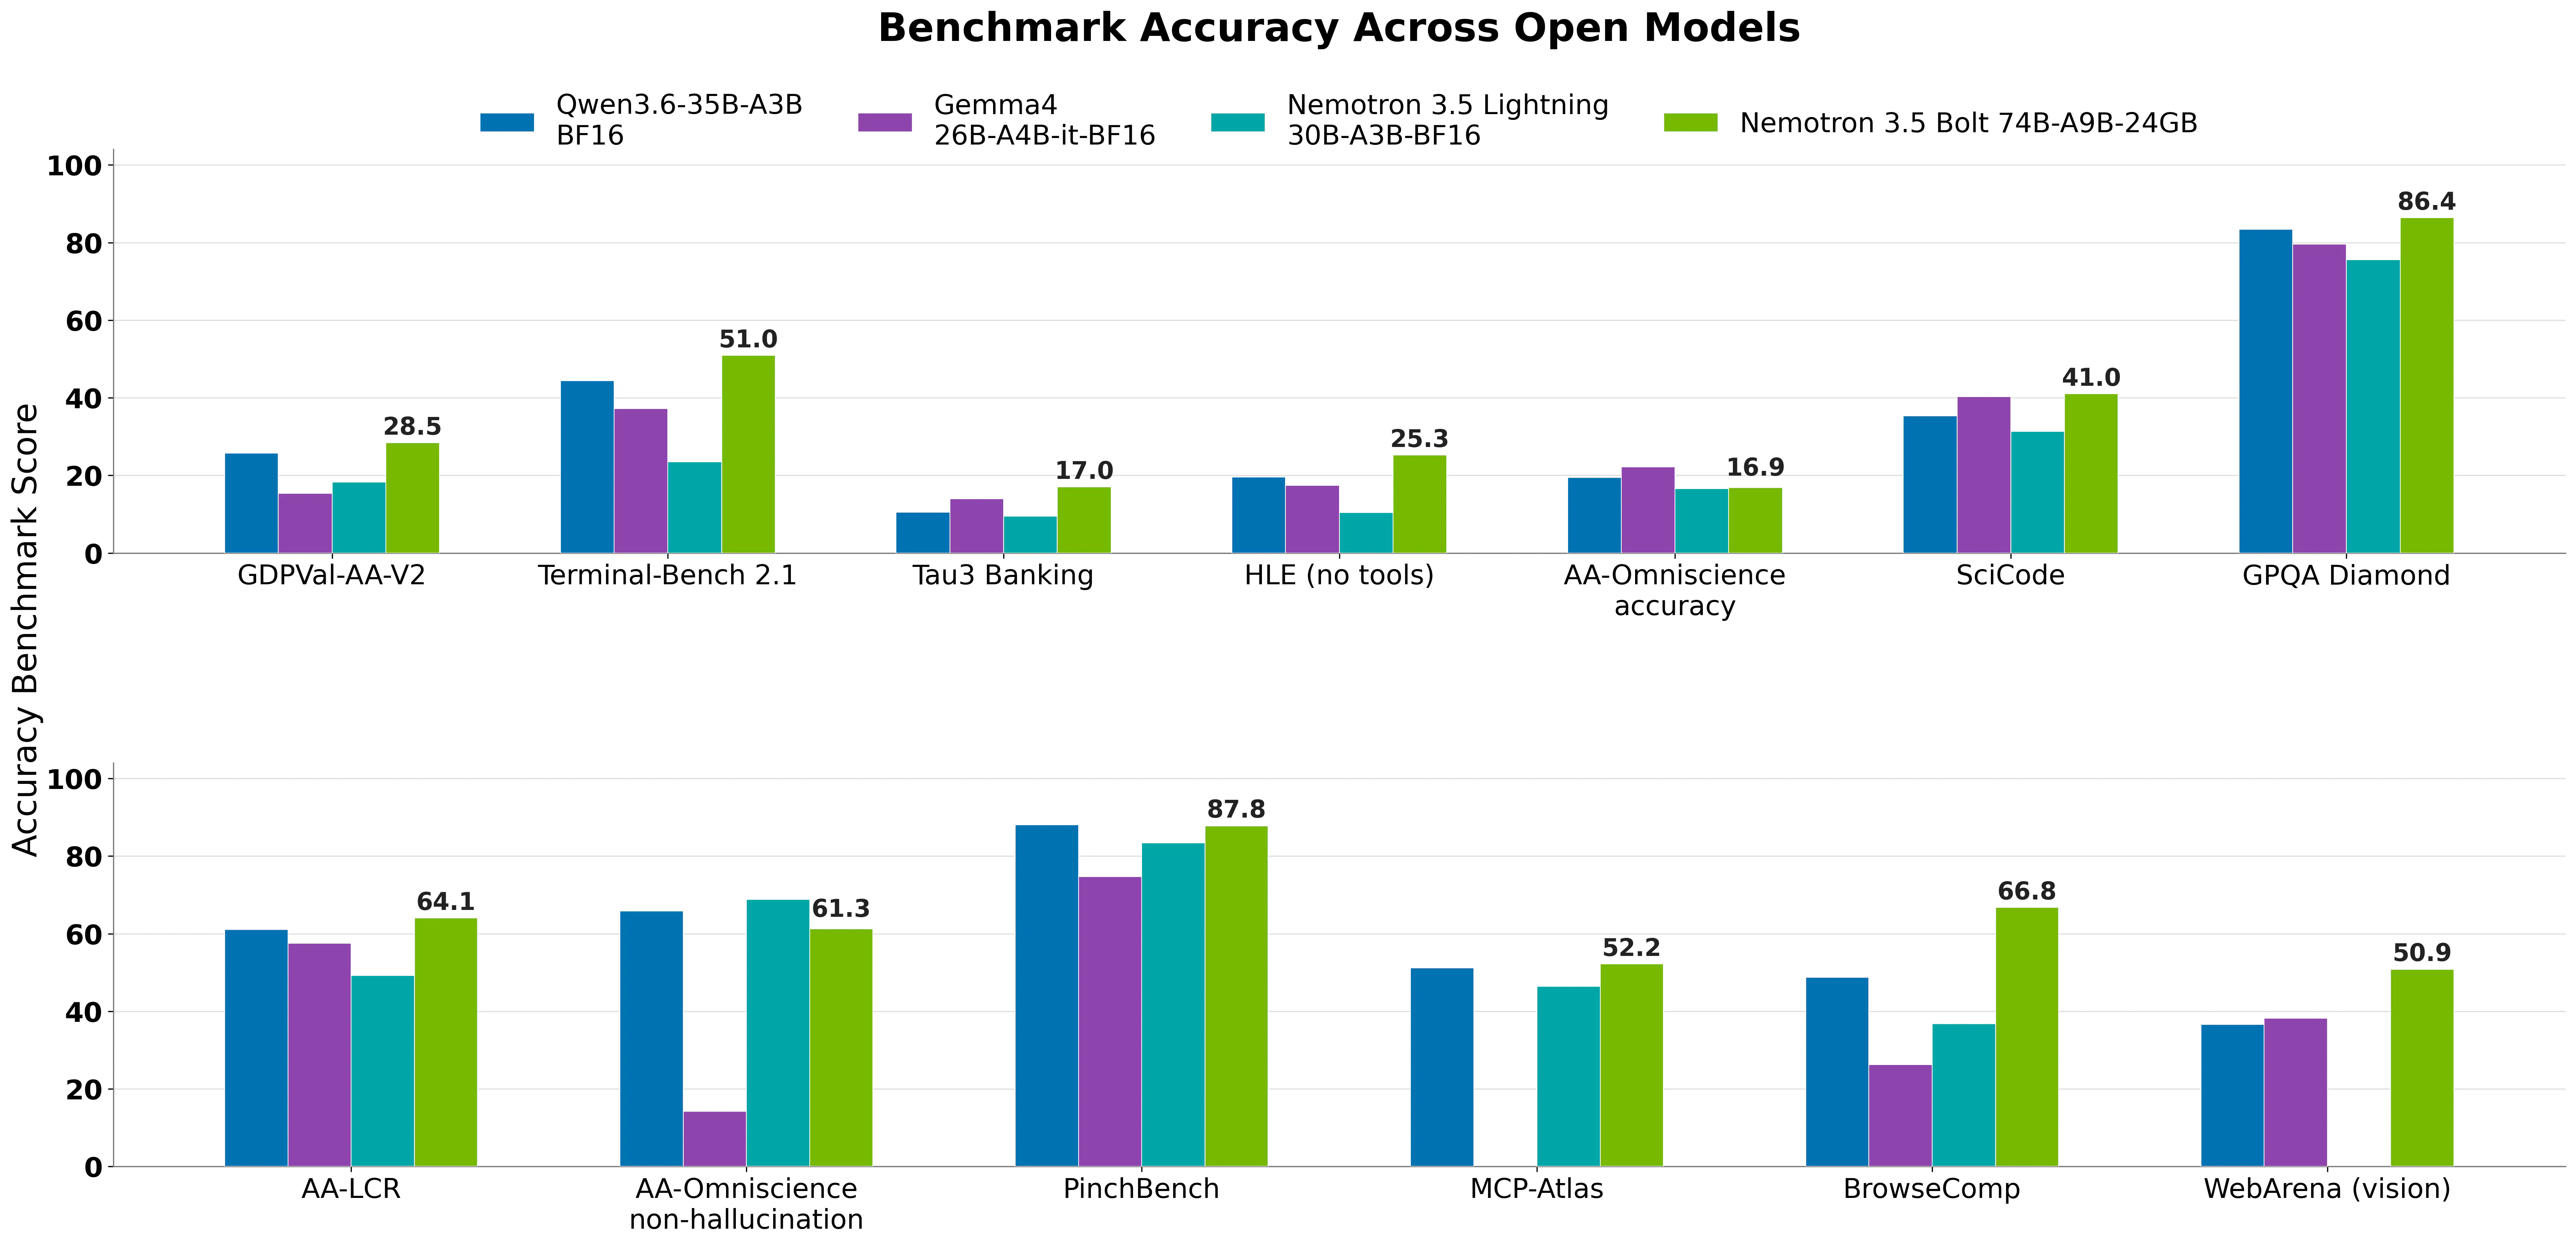
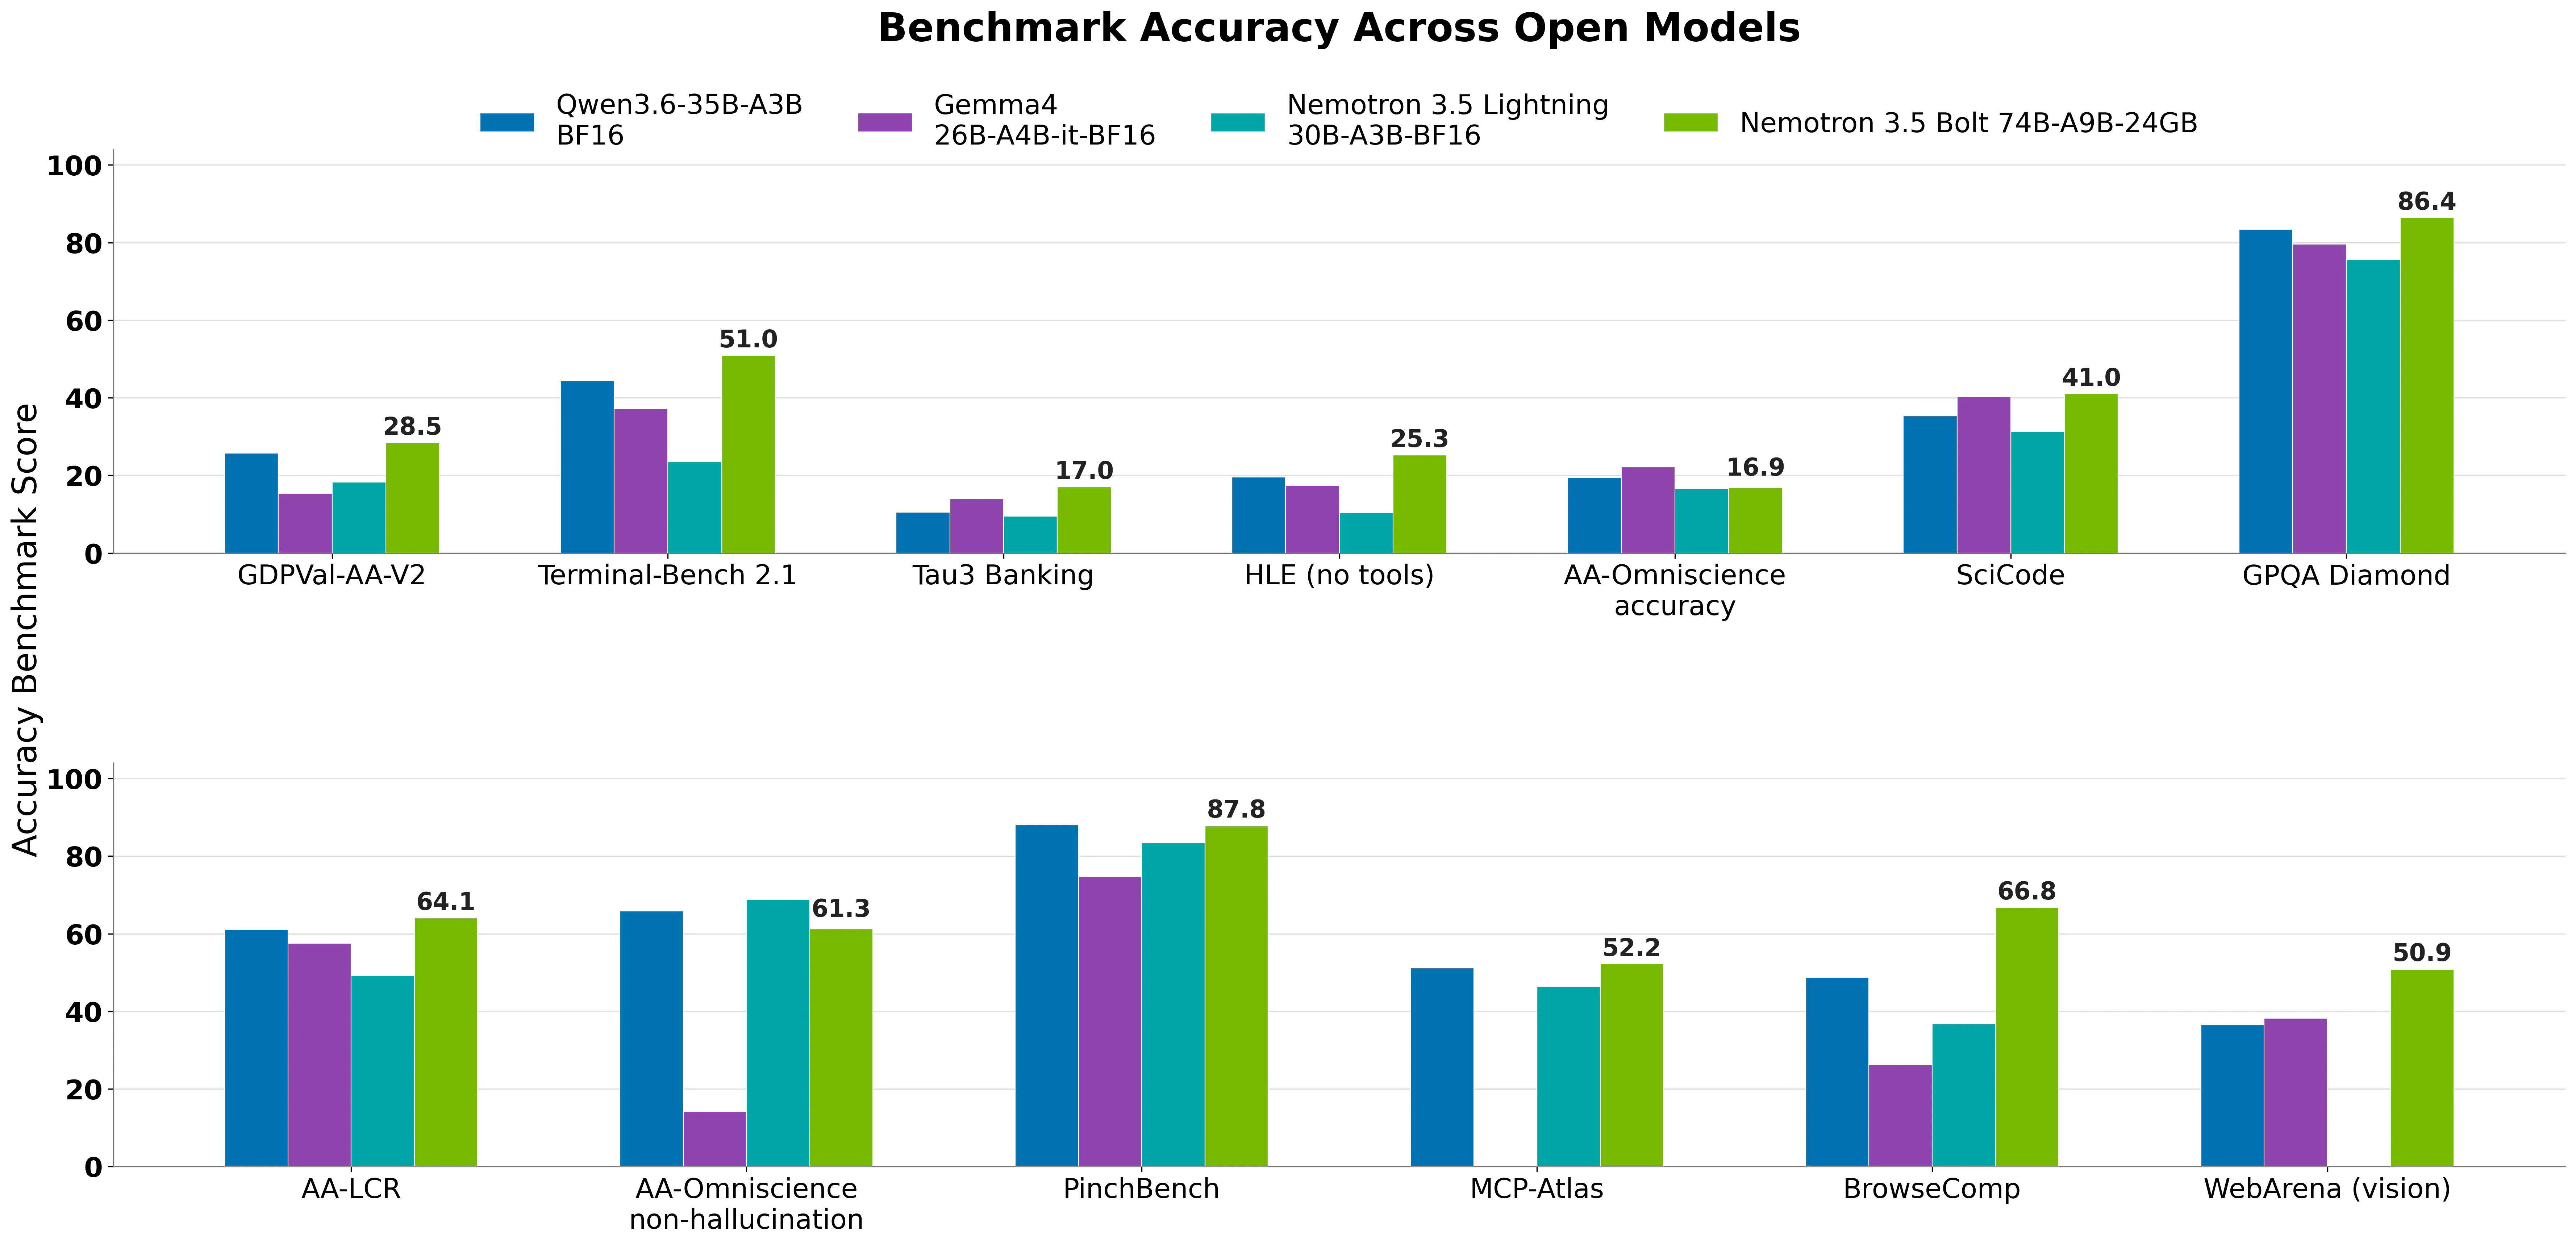
- Webブラウジング、ツール操作、ターミナル作業など、日常的なエージェントワークロードを想定しています。
こんな人におすすめ
- クラウドへデータを送らず、開発環境内でAIエージェントを構築・検証したい開発者に適しています。
- プライベートな調査、自動化、コーディング、ブラウジングなどの処理を、手元のNVIDIA GPUで実行したい人に向いています。
- Hugging Faceで提供されるチェックポイントやGGUF、カスタマイズ可能なモデルを使い、用途に合わせて検証したい人におすすめです。
投票数: 0