ElevenLabs Realtime
ストックにはログインが必要です
最初の音声まで570ミリ秒。リアルタイム音声エージェント向けモデル
Artificial Intelligence
概要
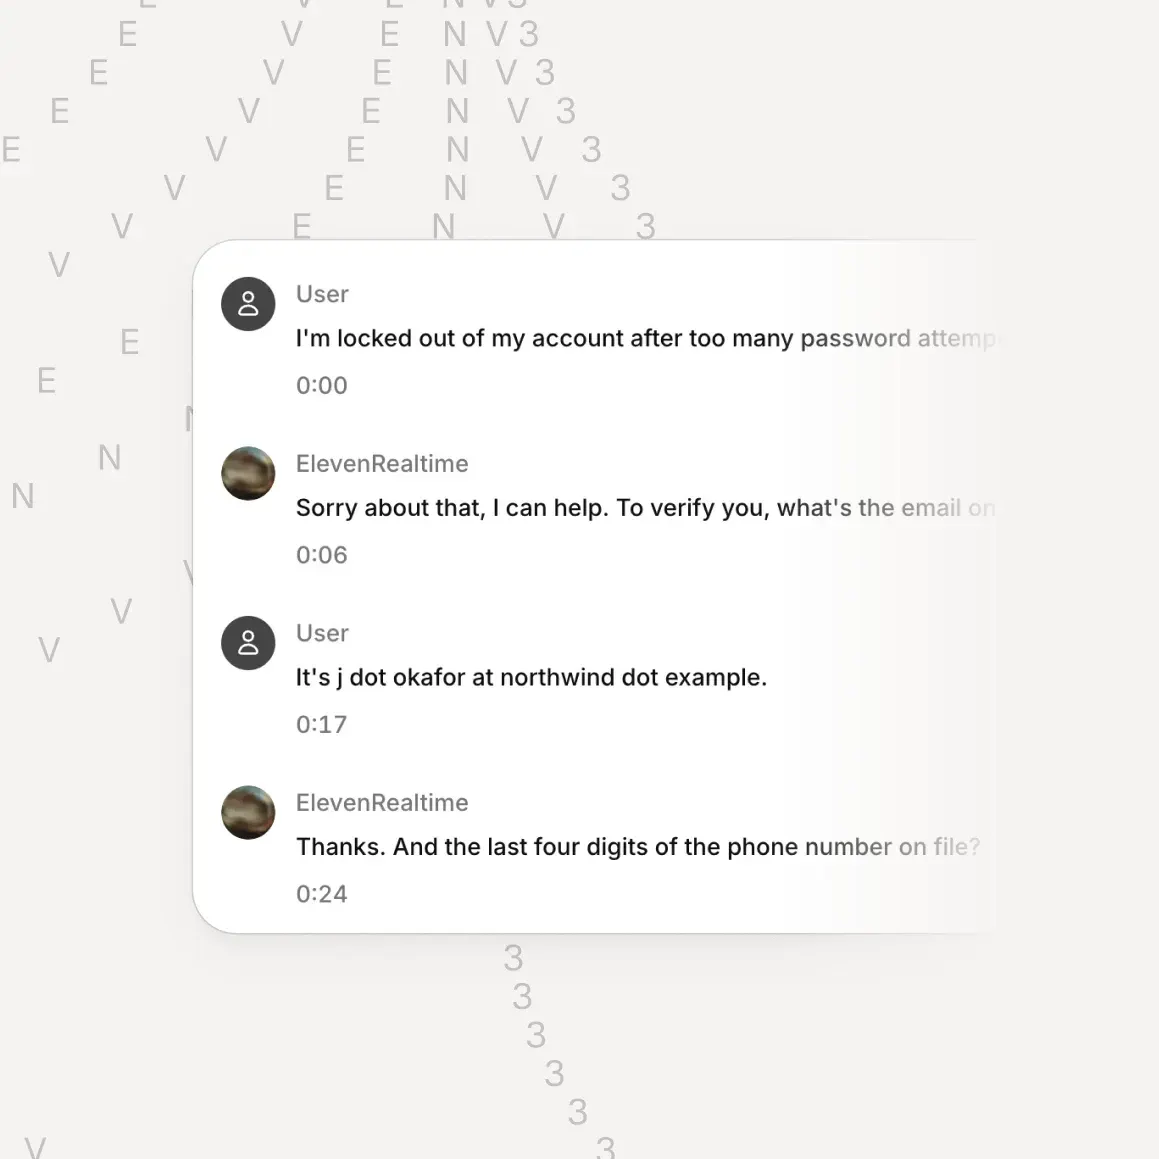
- 音声認識から発話の切り替え、LLM、音声合成までを一体として調整し、自然でテンポのよい音声対話を実現するモデル群です。
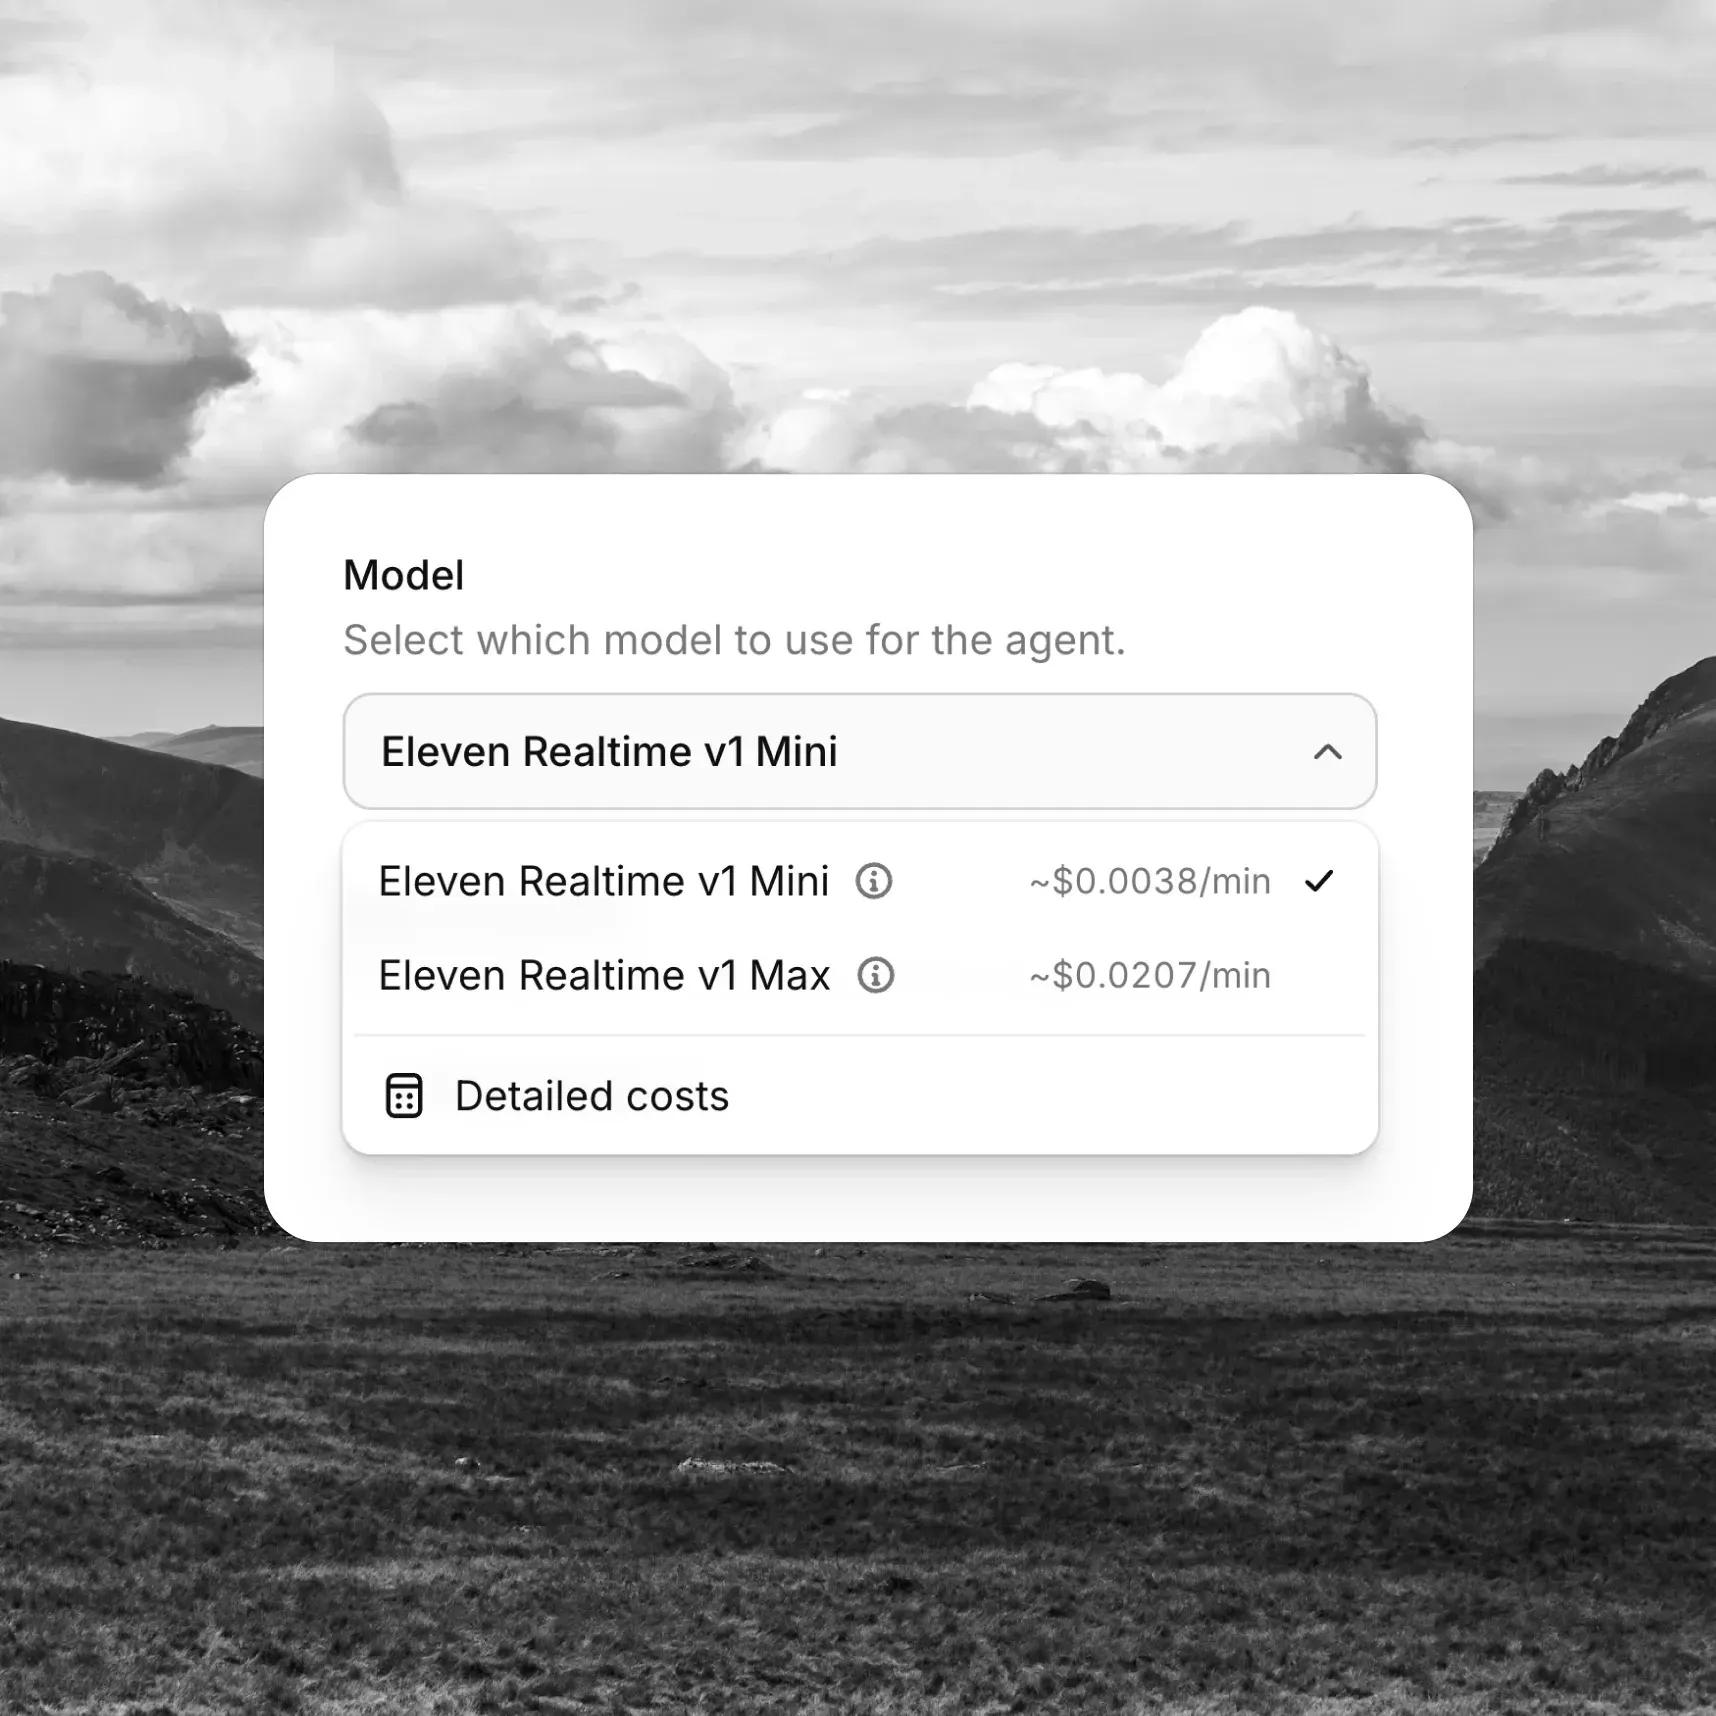
- v1 Miniは自然な会話、v1 Maxは複雑な問い合わせや正確な回答が求められる業務向けに設計されています。
- 90以上の言語に対応し、最初の音声までの時間はv1 Miniが620ミリ秒、v1 Maxが570ミリ秒とされています。
主な特徴
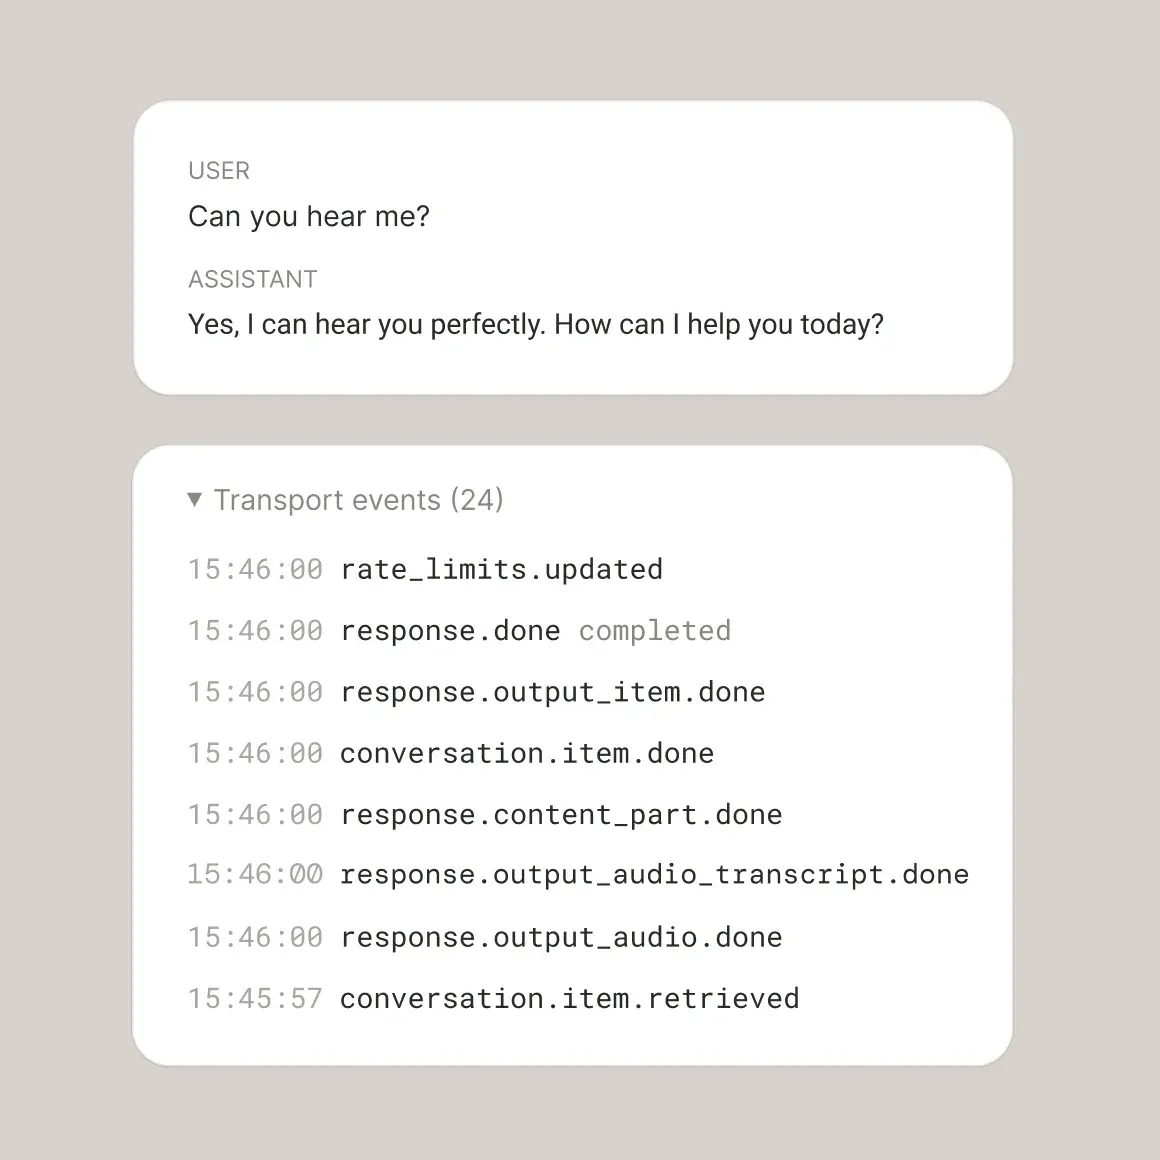
- OpenAI互換のRealtime APIを利用でき、既存アプリはエンドポイントとモデル名を変更するだけで移行しやすく、イベント処理も継続利用できます。
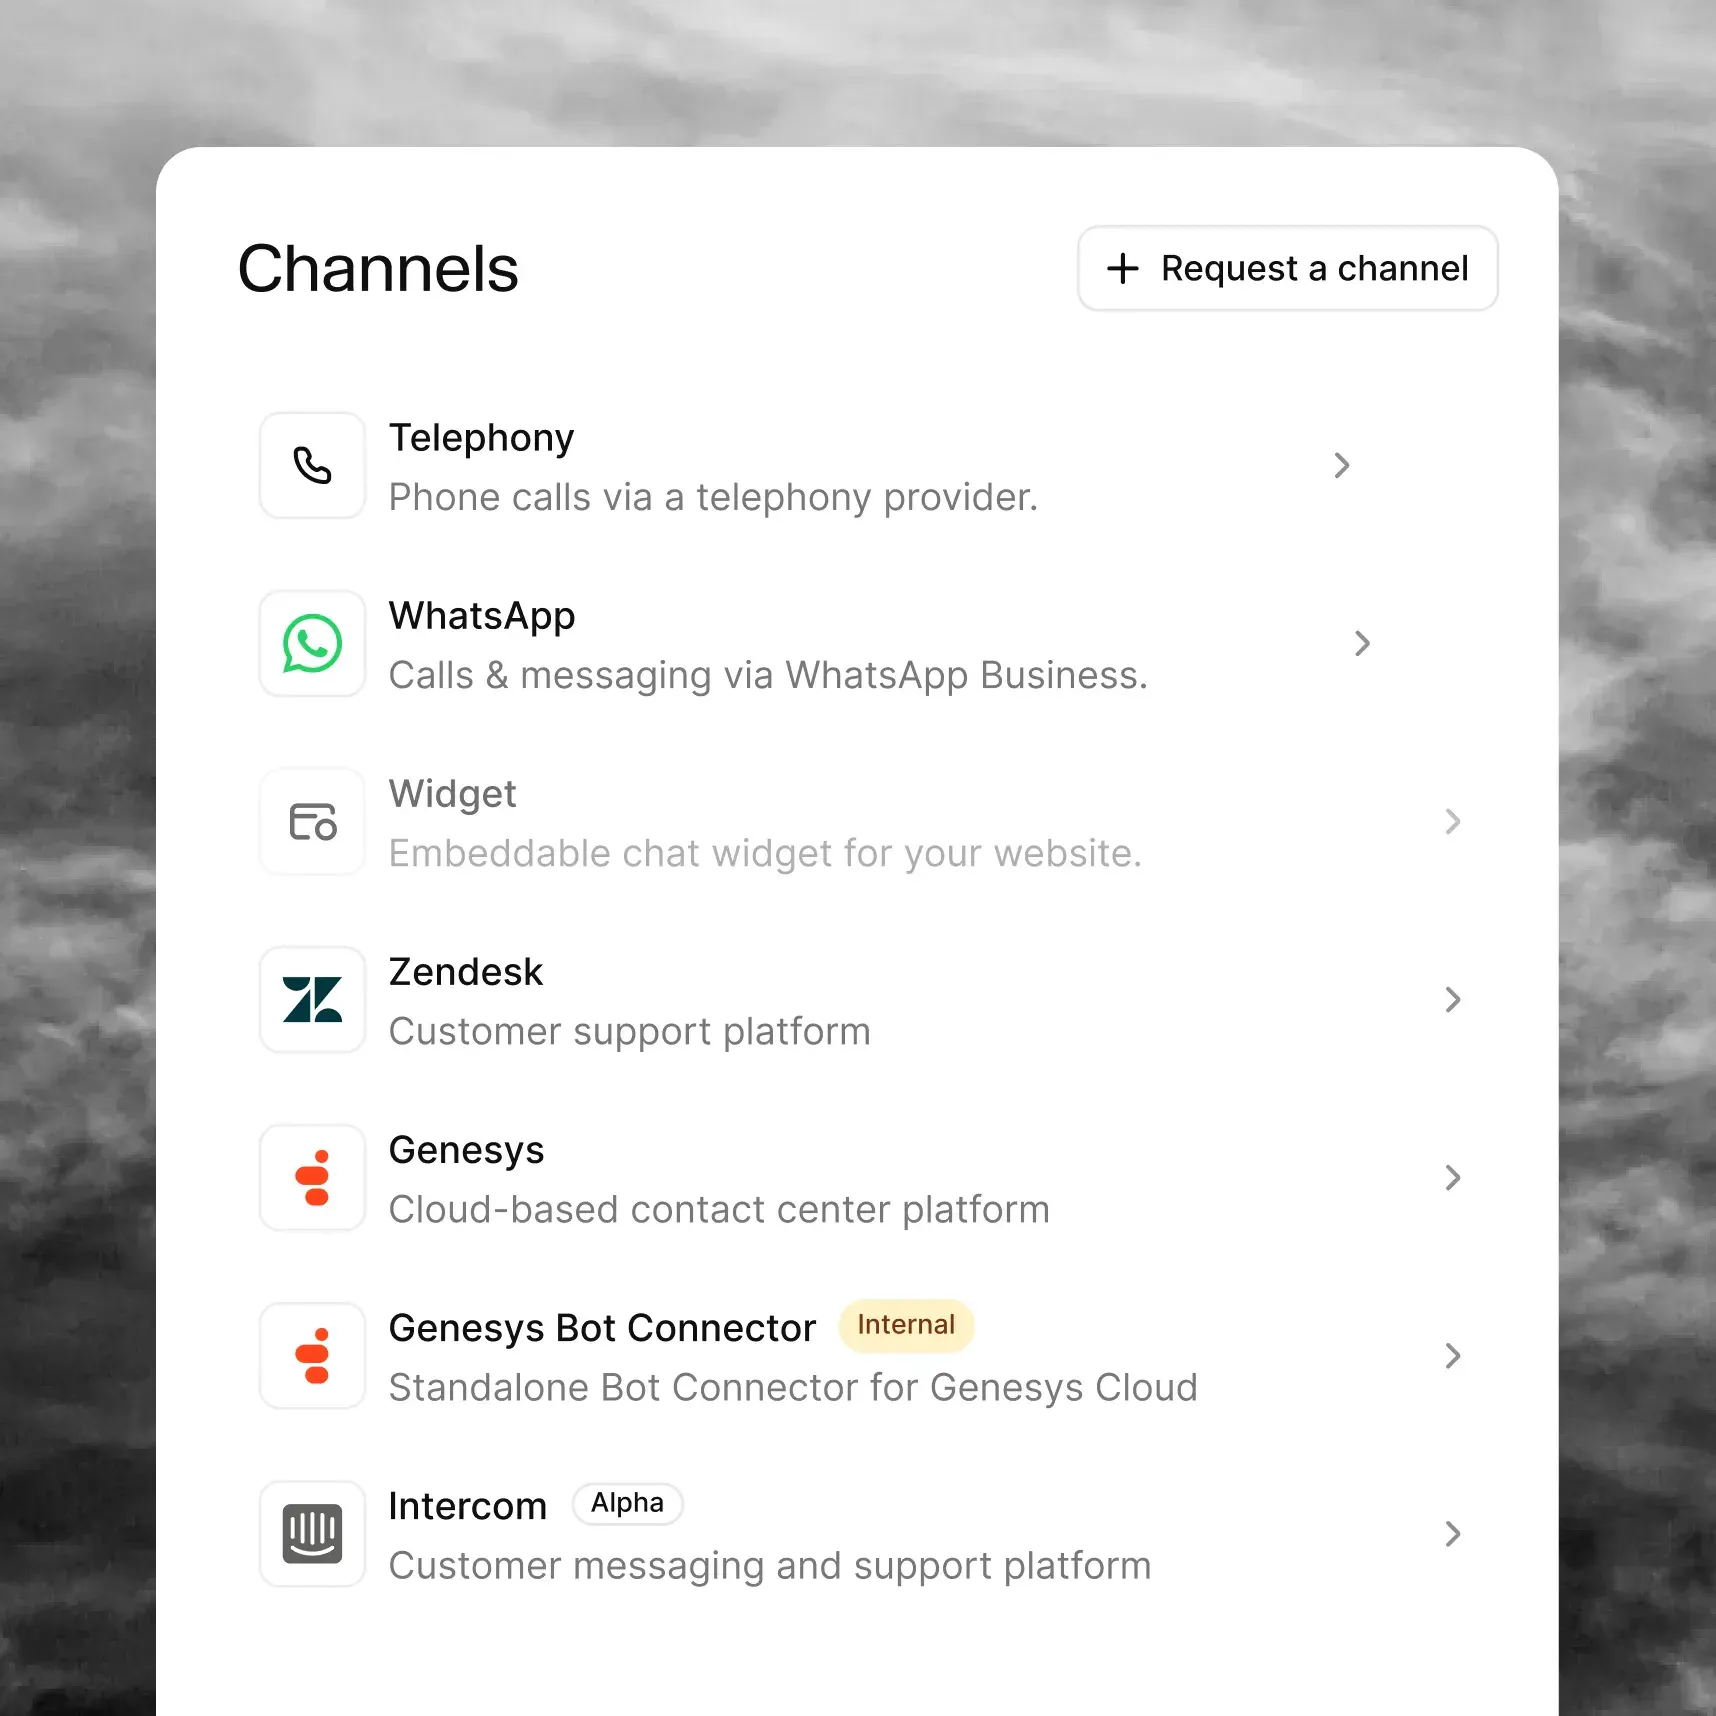
- ElevenAgentsではモデルを選ぶだけで、文字起こし、発話の切り替え、音声設定をまとめて構成でき、電話やWeb、WhatsAppなどへ展開できます。
- ナレッジベース、ガードレール、シナリオテスト、本番監視、検索・監査可能な会話ログなど、運用に必要な機能を備えています。
こんな人におすすめ
- カスタマーサポート、営業、予約受付、教育などで、会話の間や割り込みを改善した自然な音声エージェントを構築したい開発者やチームに適しています。
- 音声認識、LLM、ターン制御、音声合成を個別に接続・調整する負担を減らし、短期間で音声アプリを実装したい場合に向いています。
- SOC 2、HIPAA、GDPR対応やEUデータレジデンシー、データ保持なしのモードなど、企業向けの運用要件を重視する組織にも適しています。
投票数: 181