Hlas-1
ストックにはログインが必要です
表現力と制御性を兼ね備えた、35億パラメータのオープンウェイト音声モデル
Artificial Intelligence
Developer Tools
Audio
概要
- Hlas-1は、文章の内容だけでなく、感情や演技、話すテンポまで一体的に指定できる音声合成モデルです。
- Breeze TTS 2をベースに開発された個人プロジェクトで、24kHz音声とストリーミング実行に対応しています。
主な特徴
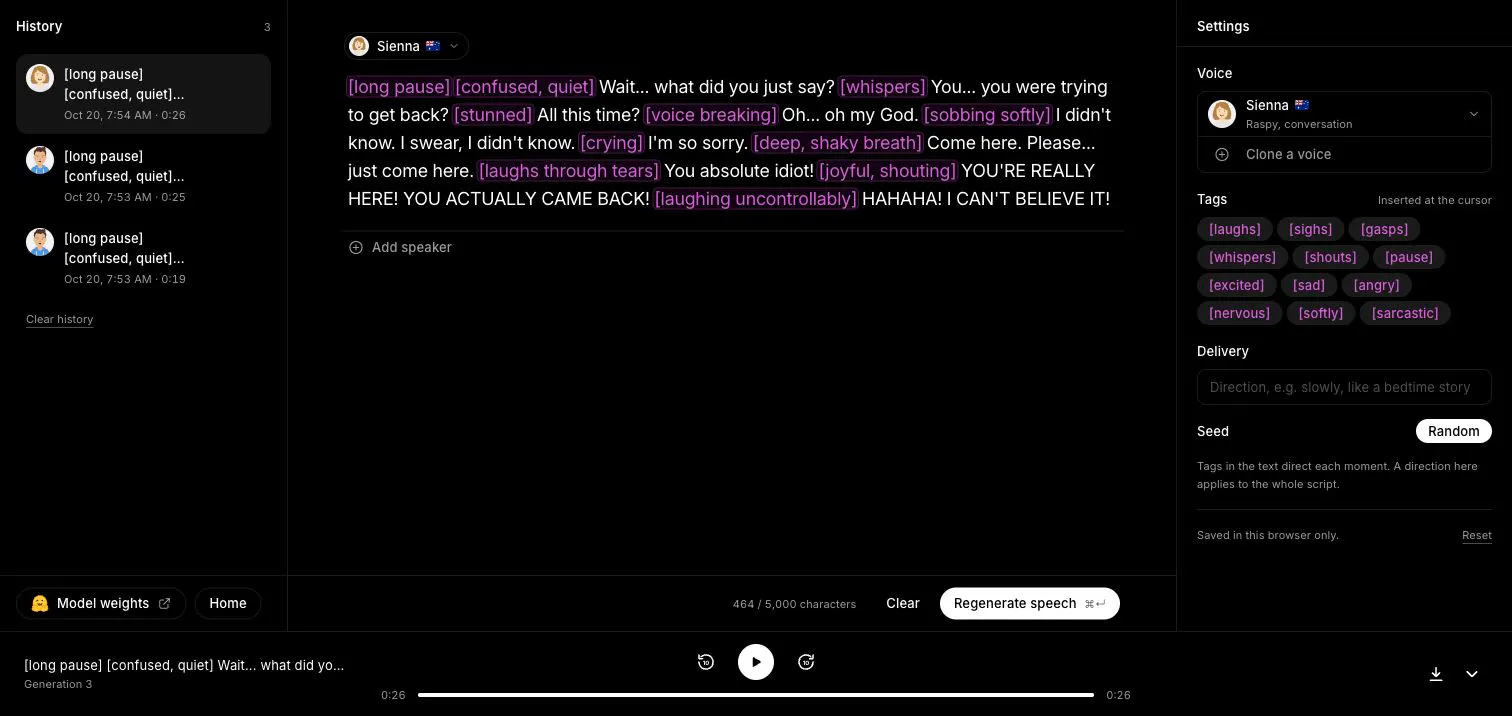
- [whispers]や[laughs]、[long pause]などのインラインタグで、ささやき・笑い・間などを指定できます。
- 「緊張しながら自信ありげに話す」のような自由記述の指示にも対応し、声の感情や変化を細かく演出できます。
- 短い音声サンプルからのボイスクローニング、多言語音声生成、35億パラメータのオープンウェイト提供に対応しています。
こんな人におすすめ
- ナレーションや動画、ゲーム、音声コンテンツで、自然な感情表現や独特な話し方を試したい開発者・クリエイター。
- 音声合成モデルの研究や実験を行い、感情・間・テンポをテキストから制御する仕組みに関心がある人。
投票数: 0