Viggle JST-2
ストックにはログインが必要です
JST-2:1つのモデルで3Dシーン、キャラクター、モーションを生成
Artificial Intelligence
概要
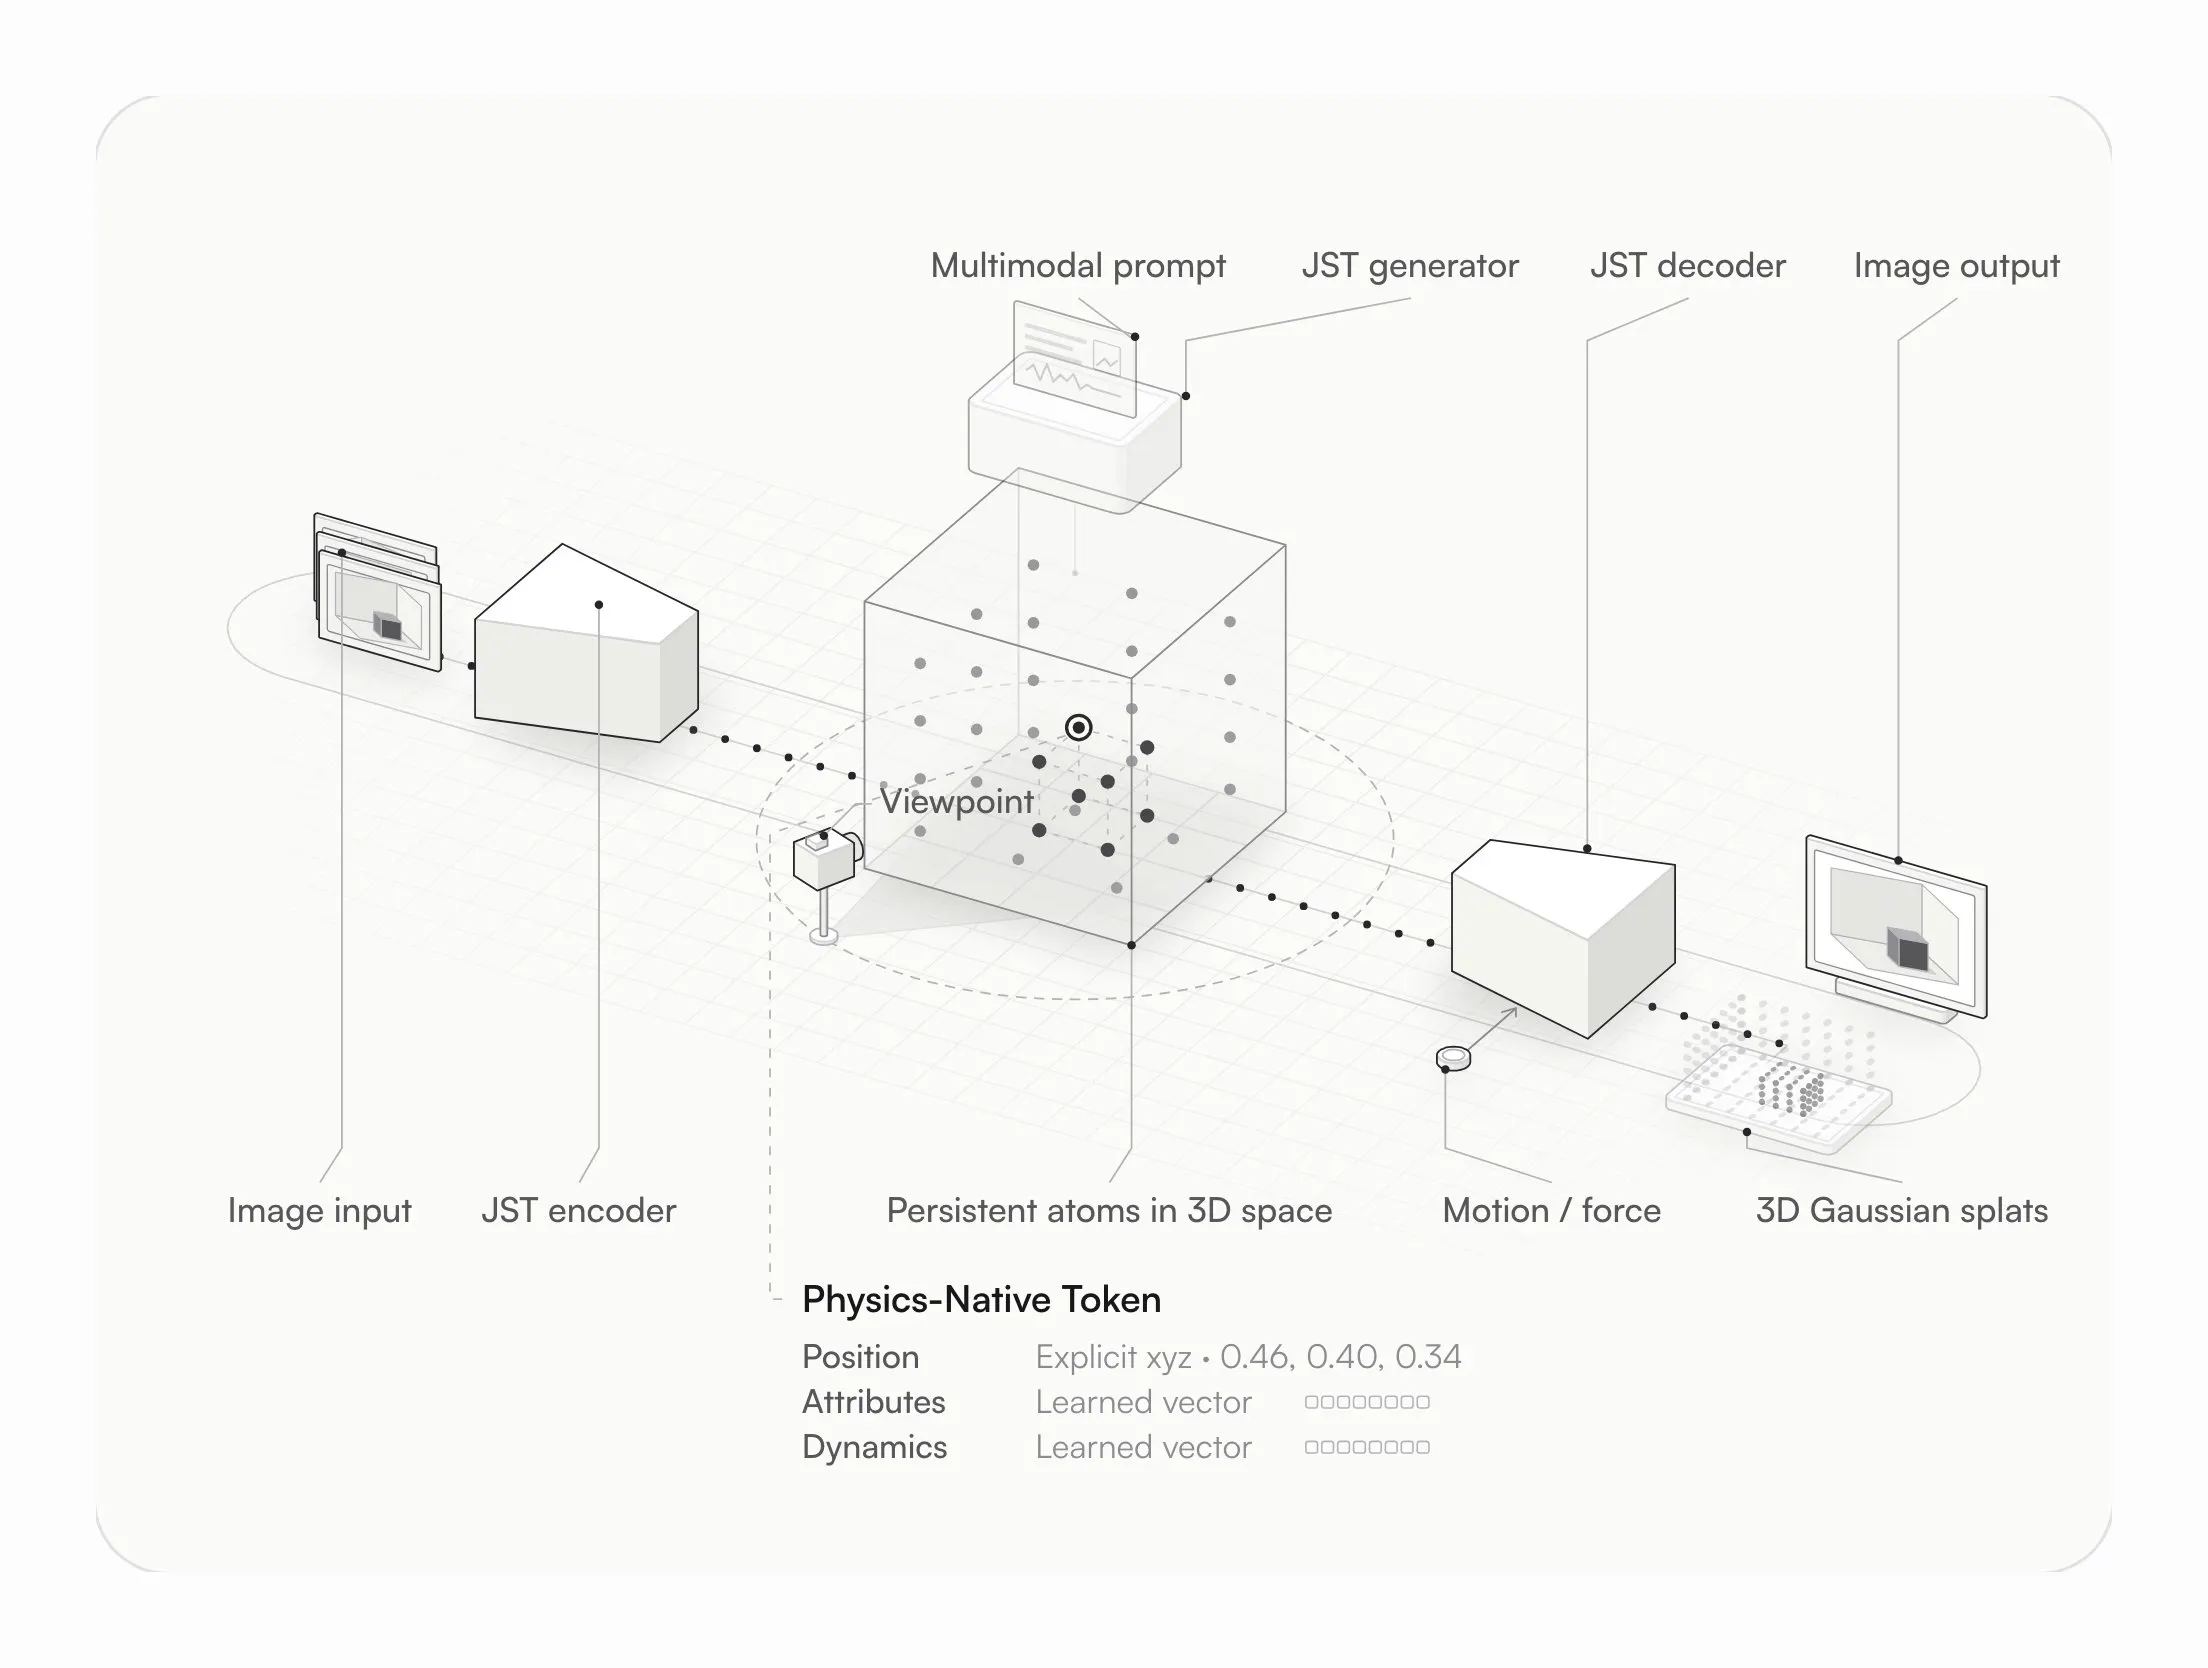
- JST-2は、3Dシーン、キャラクター、全身モーションを同一の共有3Dワールド内で扱える、Viggleの物理ネイティブな基盤モデルです。
- 世界を永続的な3D「原子」として表現し、物理ネイティブトークンを通じて画像や3D Gaussian splatへ変換します。
- シーン生成は約1秒、1シーンあたりの推論コストは0.01ドル未満とされ、PINOC、API、MCPから利用できます。
主な特徴
- テキストや画像から3Dシーンを生成し、最大64視点の入力による段階的なワールド拡張や、実環境の再構成にも対応します。
- 1枚の画像またはテキストから、顔や指先まで表現した全身3Dキャラクターを生成。リギングやスキニングを別途行わず、モーションを組み込めます。
- テキストまたは動画から全身3Dモーションを生成し、JST-2のキャラクターや標準的な3Dリグへ直接適用できます。
こんな人におすすめ
- 複数のツールをつなぎ合わせずに、シーン制作からキャラクター生成、アニメーションまで一貫して進めたい3Dアーティスト。
- ゲームやアニメーションの開発で、モデリング、リギング、モーション制作にかかる時間を短縮したいチーム。
- ロボットシミュレーションや身体性AI向けに、実環境の再構成や動作生成を効率化したい研究・開発チーム。
投票数: 0